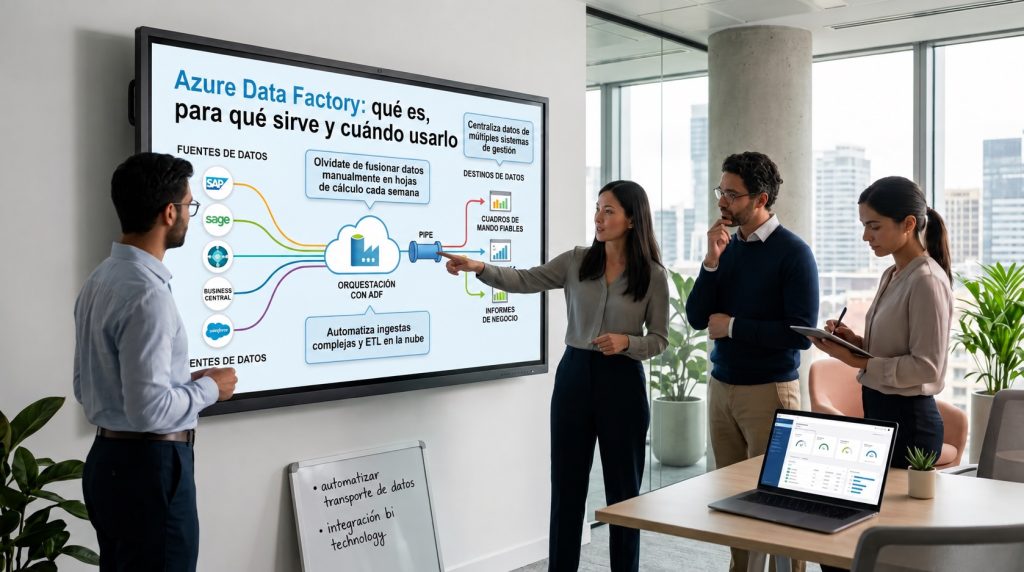
Azure Data Factory es el servicio de integración de datos en la nube de Microsoft que orquesta la extracción, transformación y carga de información entre sistemas heterogéneos. Permite mover datos desde un ERP, una base de datos o un fichero hacia un almacén analítico de forma automatizada, sin intervención manual y a cualquier escala.
Qué es Azure Data Factory y qué resuelve
La mayoría de las empresas que llevan unos años creciendo acaban con el mismo problema: los datos viven en sitios distintos y alguien dedica tiempo cada semana a unirlos a mano. Se exporta un fichero del ERP, se carga en una hoja de cálculo, se cruza con otro fichero de ventas y, al final, el informe llega tarde y con un margen de error que nadie se atreve a cuantificar.
Azure Data Factory —ADF en su abreviatura habitual— es la respuesta de Microsoft a ese problema dentro del ecosistema Azure. Técnicamente es un servicio gestionado de ETL en Azure y orquestación de flujos de datos: permite definir de dónde vienen los datos, qué transformaciones hay que aplicarles y adónde tienen que llegar, y luego ejecuta ese proceso de forma automática según la programación que se establezca.
Lo que distingue a ADF de una simple tarea programada es su capacidad para coordinar operaciones complejas entre decenas de orígenes distintos, gestionar reintentos ante fallos, registrar cada ejecución y escalar el procesamiento según el volumen. El servicio corre en la nube de Microsoft: no hay infraestructura que aprovisionar ni servidores que mantener.
Dicho esto, hay una advertencia que conviene hacer desde el principio: Data Factory mueve y transforma datos, pero no decide qué significa cada dato. Si los sistemas de origen tienen definiciones inconsistentes —clientes duplicados, centros de coste sin criterio unificado, fechas en formatos distintos—, ADF automatizará el traslado de ese desorden. Sin un acuerdo previo sobre las reglas de negocio, la herramienta no resuelve el problema de fondo.
Sus piezas explicadas sin jerga
La arquitectura de Azure Data Factory se apoya en cinco conceptos que aparecen constantemente en su interfaz y en su documentación. Entenderlos evita confusión al planificar un proyecto:
- Pipeline: la unidad de trabajo principal. Un pipeline es un flujo que agrupa una serie de actividades con un orden lógico. Equivale, de forma aproximada, al concepto de «proceso» en cualquier herramienta ETL clásica. Los pipelines de datos en Azure pueden ser tan sencillos como copiar un fichero o tan complejos como orquestar transformaciones en varios sistemas en paralelo.
- Actividad: cada paso dentro de un pipeline. Hay actividades de copia, de transformación, de ejecución de procedimientos almacenados, de llamadas a funciones o de espera condicional. ADF incluye más de noventa actividades predefinidas.
- Conjunto de datos: la descripción de los datos que se leen o escriben en cada actividad. Define la estructura esperada: columnas, tipos, formato del fichero, nombre de la tabla.
- Servicio vinculado: la credencial y la dirección de conexión hacia un sistema externo —una base de datos, un almacenamiento, una API—. Es el equivalente a una cadena de conexión gestionada de forma centralizada y segura.
- Disparador: la regla que determina cuándo se ejecuta un pipeline. Puede ser un horario fijo, la llegada de un fichero a una carpeta o un evento externo.
Con estos cinco elementos se construye prácticamente cualquier flujo de integración de datos en Azure. La interfaz visual de ADF permite diseñarlos sin escribir código, aunque para transformaciones complejas se puede incorporar Spark a través de Azure Databricks o usar los flujos de datos de mapeo propios de la herramienta.
¿No tienes claro si Azure Data Factory encaja con tus sistemas actuales?
Revisamos tu situación y te orientamos sin compromiso. Respuesta en menos de 24 horas.
Contactar un especialistaCon qué sistemas se conecta
Uno de los puntos fuertes de ADF es su catálogo de conectores. En el momento de publicar esta guía supera los cien orígenes y destinos certificados, lo que cubre prácticamente cualquier escenario habitual en empresas españolas:
- ERPs y CRMs: SAP (incluyendo SAP HANA, SAP BW y SAP ECC mediante el conector SAP CDC), Sage, Microsoft Business Central, Salesforce, Dynamics 365, Holded a través de su API REST.
- Bases de datos relacionales: SQL Server, Azure SQL Database, PostgreSQL, MySQL, Oracle, Teradata.
- Almacenamiento de ficheros: Azure Data Lake Storage, Azure Blob Storage, SFTP, FTP, Amazon S3, Google Cloud Storage. Incluye ficheros CSV, Excel, Parquet, Avro y JSON.
- Servicios analíticos: Azure Synapse Analytics, Azure Databricks, Power BI Datasets, Snowflake.
- Servicios web y APIs: HTTP genérico, REST, OData. Permite conectar con cualquier sistema que exponga una API estándar.
Para entornos locales —servidores on-premise o redes privadas— existe el Integration Runtime autohospedado: un agente que se instala en un servidor de la empresa y actúa como puente entre la red interna y el servicio en la nube. Esto permite incluir en los pipelines sistemas que no están expuestos a internet, como una instancia de SQL Server en el centro de datos propio.
Cuando el reto no es construir pipelines de datos en Azure sino conectar directamente el software de gestión con capacidades analíticas sin obra de infraestructura, una alternativa más directa es INTEGRA HUB, el producto propio de Tecnología bi diseñado para integrar Business Intelligence y habilitar Inteligencia Artificial sobre el ERP o sistema de gestión ya existente, con verticales para retail, seguros y consignatarios.
Cuándo conviene y cuándo es matar moscas a cañonazos
Azure Data Factory tiene sentido cuando se cumple al menos una de estas condiciones:
- Hay más de tres o cuatro orígenes de datos que necesitan integrarse de forma regular.
- El volumen supera lo que Power Query puede procesar en tiempos razonables (generalmente, decenas de millones de filas o ficheros de más de varios cientos de megabytes).
- Se necesita garantía de entrega, reintentos automáticos y trazabilidad de cada ejecución.
- El proceso tiene dependencias complejas: paso B solo puede ejecutarse si el paso A termina sin errores, y paso C en paralelo con B.
- La organización ya opera en Azure y tiene sentido consolidar la capa de integración en el mismo ecosistema.
En cambio, hay escenarios en los que ADF añade complejidad sin aportar valor proporcional:
- Si los orígenes son dos o tres y el volumen es manejable, Power Query —ya sea en Power BI Desktop, en Excel o en Power BI Dataflows— resuelve el mismo problema por una fracción del coste y sin infraestructura que gestionar.
- Si el equipo no tiene experiencia en Azure y el proyecto no justifica la curva de aprendizaje, el tiempo de puesta en marcha puede superar el beneficio.
- Si la integración es puntual y no recurrente, un script Python o una exportación manual es suficiente.
La regla práctica: si alguien en el equipo une datos a mano cada semana y el proceso tarda más de una hora, merece la pena evaluar ADF. Si el proceso tarda quince minutos y funciona, no lo cambies solo por modernizarlo.
¿Alguien de tu equipo une datos a mano cada semana?
En cinco minutos identificamos tu nivel de madurez de datos y qué herramienta encaja mejor. Sin coste, sin compromiso.
Hacer tu diagnóstico gratuitoCuánto cuesta y qué dispara la factura
Azure Data Factory no tiene una cuota fija mensual: se paga por consumo. Entender el modelo de coste evita sorpresas en la factura de Azure.
Los tres factores que determinan el gasto son:
- Ejecuciones de actividades: cada actividad ejecutada dentro de un pipeline tiene un coste por unidad. Las primeras mil actividades al mes tienen un cargo mínimo; a partir de ahí, el coste por actividad cae progresivamente.
- Unidades de integración de datos (DIU): al copiar datos entre sistemas, ADF asigna recursos de computación medidos en DIUs. Cuantas más DIUs, más rápida la copia pero mayor el coste. Se pueden configurar manualmente o dejar que ADF las ajuste de forma automática.
- Integration Runtime autohospedado: si se usa el agente para conectar sistemas locales, no hay coste directo por el propio agente, pero el servidor donde se instala sí tiene su coste (bien en Azure si es una máquina virtual, bien en el centro de datos propio).
Un escenario típico de empresa mediana —diez pipelines ejecutándose una vez al día, volúmenes de entre uno y cinco millones de filas— suele representar entre treinta y cien euros al mes en ADF puro, sin contar el almacenamiento de destino ni otros servicios asociados. Los costes escalan cuando hay pipelines muy frecuentes (cada cinco minutos, por ejemplo) o transformaciones intensivas con muchas DIUs durante horas.
La recomendación es activar las alertas de presupuesto de Azure desde el primer día y revisar el desglose de costes en el portal al menos una vez a la semana durante el primer mes de uso.
Data Factory y Microsoft Fabric: cómo encajan
Desde que Microsoft lanzó Microsoft Fabric, la pregunta que reciben con más frecuencia los equipos que trabajan con datos en Azure es: ¿tiene sentido seguir invirtiendo en ADF o conviene mirar hacia Fabric?
La respuesta corta es que ambas herramientas coexisten y, en muchos casos, se complementan. Fabric incluye sus propias capacidades de integración —Data Factory dentro de Fabric es, de hecho, una evolución del ADF clásico— pero está orientado a organizaciones que adoptan Fabric como plataforma analítica unificada. Si la empresa ya tiene cargas de trabajo en Synapse, Power BI Premium y quiere consolidarlo todo, Fabric es el paso natural.
Si, en cambio, la organización tiene Azure pero no ha adoptado Fabric, ADF standalone sigue siendo la opción más madura, con mayor catálogo de conectores y sin necesidad de adquirir una capacidad Fabric (que se factura de forma diferente, por unidades de capacidad). No hay urgencia en migrar: Microsoft ha confirmado que ADF continuará siendo un servicio activo y con soporte a largo plazo.
El momento de plantearse el salto a Fabric es cuando la organización necesita un lakehouse unificado, quiere consolidar BI, ingeniería de datos y ciencia de datos en un único entorno, o el equipo ya trabaja con notebooks de Spark y necesita gobernanza de datos centralizada.
Revisamos tus orígenes y te decimos qué arquitectura necesitas de verdad
Tecnología bi lleva más de 15 años ayudando a empresas a diseñar arquitecturas de datos fiables.
Cuéntanos tu casoPreguntas frecuentes sobre Azure Data Factory
¿Qué es Azure Data Factory?
Azure Data Factory es el servicio de integración de datos en la nube de Microsoft. Permite extraer datos de múltiples orígenes —bases de datos, ERPs, ficheros, APIs—, aplicarles transformaciones y cargarlos en un destino analítico de forma automatizada. Es una solución ETL gestionada que no requiere gestionar servidores propios.
¿Qué diferencia hay entre Azure Data Factory y Power Query?
Power Query es adecuado para volúmenes moderados, pocos orígenes y usuarios que trabajan en Power BI o Excel. Azure Data Factory está diseñado para procesos de integración de datos en Azure a gran escala, con muchos orígenes, ejecuciones automáticas programadas, reintentos ante fallos y trazabilidad completa. Son herramientas complementarias, no competidoras directas.
¿Cuánto cuesta Azure Data Factory?
ADF se factura por consumo: se paga por ejecuciones de actividades, por las unidades de integración de datos usadas en las copias y, si aplica, por el coste del servidor donde corre el Integration Runtime autohospedado. Un escenario típico de empresa mediana puede suponer entre treinta y cien euros al mes solo en ADF, sin contar el almacenamiento de destino.
¿Azure Data Factory sustituye a un ETL tradicional?
En la mayoría de los casos, sí. ADF cubre las funciones que antes requerían herramientas ETL locales como SQL Server Integration Services (SSIS) o Informatica, con la ventaja de ser un servicio gestionado en la nube sin infraestructura que mantener. Para transformaciones muy complejas se puede combinar con Azure Databricks.
¿Únicamente funciona con servicios de Azure?
No. ADF cuenta con más de cien conectores que incluyen servicios de terceros como SAP, Salesforce, Amazon S3, Google Cloud Storage, Snowflake, bases de datos Oracle o PostgreSQL y cualquier API REST. Para sistemas locales sin exposición a internet, el Integration Runtime autohospedado actúa como puente entre la red interna y el servicio en la nube.
¿Qué pasa si mis datos de origen tienen errores o inconsistencias?
Azure Data Factory moverá y transformará los datos según las reglas que se definan en los pipelines, pero no detecta ni corrige inconsistencias de negocio de forma automática. Es fundamental acordar las reglas de calidad y limpieza antes de construir los flujos; de lo contrario, se automatiza el traslado de datos incorrectos al destino analítico.
