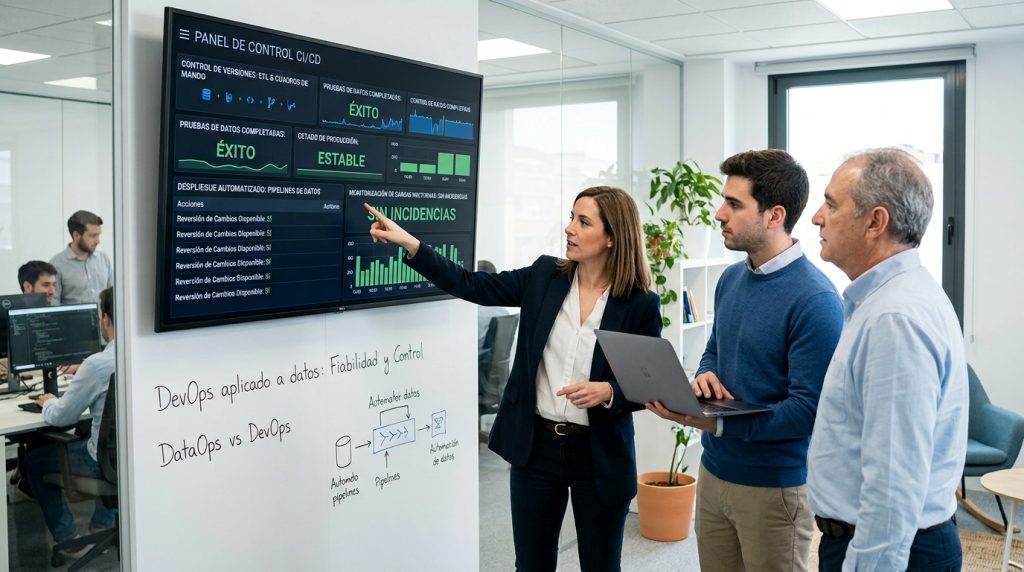
El concepto de DevOps nació en el desarrollo de software para unir los equipos de desarrollo y operaciones en un ciclo de entrega continua, controlada y reversible. Aplicado a proyectos de datos, significa exactamente lo mismo: que ningún cambio en un cuadro de mando, una transformación o un proceso de carga llegue a producción sin control de versiones, pruebas previas y capacidad de revertir.
Qué es DevOps y de dónde viene
DevOps —contracción de development y operations— es un conjunto de prácticas culturales y técnicas que elimina la frontera entre quien construye un sistema y quien lo mantiene funcionando. La idea central es sencilla: los cambios deben poder desplegarse de forma frecuente, sin miedo y sin depender de que una persona concreta esté disponible en ese momento.
Surgió en la industria del software a finales de la década de 2000 como respuesta a un problema concreto: los equipos de desarrollo entregaban código y los equipos de operaciones lo desplegaban en producción meses más tarde, con procesos manuales y una tasa de incidencias inaceptable. La solución fue automatizar el ciclo completo —desde la escritura del código hasta su puesta en marcha— y medir cada paso.
Lo que se conoce como CI/CD en datos (integración continua y despliegue continuo aplicados al mundo de los datos) es precisamente la traslación de ese ciclo al ámbito de los informes, los modelos de Machine Learning y los procesos de carga. En lugar de desplegar código de una aplicación web, se despliegan transformaciones SQL, modelos de datos o definiciones de cuadros de mando.
¿Se te rompe un informe y nadie sabe qué cambió?
Cuéntanos tu situación y te explicamos qué prácticas encajan mejor con tu equipo.
Contactar con un especialistaPor qué los proyectos de datos se rompen tanto
En la mayoría de las empresas medianas, los cuadros de mando y los procesos de carga se modifican directamente en producción. No hay un entorno de pruebas, no hay control de versiones y no existe ningún registro de quién tocó qué ni cuándo. Esta forma de trabajar tiene consecuencias concretas y repetidas:
- Un informe deja de mostrar datos correctos y nadie recuerda qué se cambió la semana anterior.
- Los cambios se prueban sobre los datos reales de la empresa porque no hay otro entorno disponible.
- No existe forma de volver a la versión anterior de un cuadro de mando si algo falla.
- Cada despliegue depende de que una persona concreta —habitualmente la misma— esté disponible para hacerlo.
- Los procesos de carga fallan de madrugada y la incidencia se descubre a la mañana siguiente cuando ya hay decisiones tomadas con datos incorrectos.
Estos problemas no son de herramientas: son de proceso. Ninguna plataforma de Business Intelligence, por muy sofisticada que sea, protege contra un cambio no controlado en la lógica de transformación que alimenta sus cuadros de mando. La herramienta solo visualiza lo que llega; si lo que llega está mal, el problema está antes.
La buena noticia es que la disciplina para evitarlo ya existe. Se llama DevOps y, en términos prácticos, consiste en un modelo de trabajo en el que cada cambio pasa por un flujo definido antes de llegar a los usuarios. No hace falta un equipo grande para empezar a aplicarlo.
¿Cuánto riesgo acumula tu empresa cada vez que alguien toca un informe en producción?
En cinco minutos identificamos los puntos de riesgo más frecuentes en proyectos de datos.
Hacer tu diagnóstico gratuitoQué cambia al aplicar DevOps a los datos
Aplicar DevOps a un proyecto de datos no significa instalar Jenkins y llamarlo cultura DevOps. Significa cambiar la forma en que el equipo gestiona el ciclo de vida de todo lo que produce: modelos de datos, transformaciones, procesos ETL, definiciones de cuadros de mando y scripts de carga. Los cambios concretos son cinco:
- Control de versiones de las transformaciones y los modelos. Cada cambio en la lógica de un proceso ETL o en un modelo de datos queda registrado en un sistema como Git. Si algo falla, se sabe exactamente qué cambió, quién lo cambió y cuándo.
- Entornos separados. Los cambios se desarrollan en un entorno de desarrollo, se prueban en un entorno de staging con datos reales (o réplicas anonimizadas) y solo llegan a producción si superan las pruebas. Nada de probar directamente sobre los datos de la empresa.
- Pruebas sobre el dato. Se definen comprobaciones automáticas que validan que los datos transformados cumplen las expectativas: rangos de valores, totales cuadrados, ausencia de nulos donde no debe haberlos. Si una prueba falla, el despliegue se detiene.
- Automatización de despliegues. La automatización de despliegues elimina la dependencia de una persona concreta. El pipeline ejecuta los pasos en orden, sin intervención manual, y registra el resultado de cada uno.
- Monitorización de las cargas. Una vez en producción, los procesos de carga generan alertas cuando fallan o cuando los datos que producen están fuera de los rangos esperados. La incidencia se detecta en tiempo real, no horas después.
Para proyectos que involucran integración de datos entre varios sistemas —ERP como SAP, Sage, Business Central o Holded, y plataformas analíticas—, este flujo controlado es especialmente crítico. Un cambio en el esquema del sistema fuente puede romper toda la cadena de transformación si no hay ningún proceso que lo detecte antes de que llegue al cuadro de mando del director financiero.
DevOps y DataOps: qué los diferencia
El término dataops aparece con frecuencia junto a DevOps en conversaciones sobre datos, y conviene distinguirlos con precisión para no mezclar conceptos que, aunque relacionados, tienen alcances distintos.
DevOps es una disciplina de ingeniería de software que se aplica a cualquier tipo de producto digital, incluidos los proyectos de datos. Sus principios —integración continua, entrega continua, automatización, colaboración entre equipos— son de propósito general.
DataOps no es simplemente DevOps aplicado a los datos. Toma principios de varias disciplinas —DevOps, metodologías ágiles y control estadístico de procesos, entre otras— y los adapta al ciclo de vida del dato: desde su ingesta hasta su consumo en un informe o un modelo predictivo. Por eso incorpora cuestiones propias del mundo del dato que DevOps no contempla: linaje del dato, calidad de datos como parte del pipeline, gobierno y trazabilidad de las transformaciones.
En la práctica, una empresa que adopta una cultura DevOps en sus proyectos de datos está, sin saberlo, haciendo DataOps. La diferencia no es de herramientas sino de enfoque: DataOps pone el dato en el centro y adapta las prácticas de DevOps a sus particularidades. Ambos términos son complementarios, no excluyentes.
¿Cómo se controlan los procesos de carga entre tu ERP y tu plataforma analítica?
Descubre cómo integramos BI e IA directamente sobre tu software de gestión con control total del ciclo de datos.
Conocer INTEGRA HUBPor dónde empezar sin montar una plataforma entera
Una objeción habitual cuando se habla de DevOps en equipos de datos es que parece pensado para empresas con departamentos de ingeniería de decenas de personas. No es así. Una empresa mediana puede empezar con tres pasos concretos que no requieren una plataforma nueva ni meses de implantación:
- Paso 1: versionar lo que ya tienes. Mover las transformaciones, los scripts de carga y las definiciones de los cuadros de mando a un repositorio Git es el primer cambio y el más importante. No importa si el equipo es de dos personas: el historial de cambios es inmediatamente valioso.
- Paso 2: separar producción del desarrollo. Crear un entorno de pruebas —aunque sea una réplica parcial de los datos— elimina el mayor riesgo: probar sobre datos reales. En entornos Power BI, por ejemplo, los espacios de trabajo de desarrollo y producción permiten hacer esto sin infraestructura adicional.
- Paso 3: añadir comprobaciones automáticas básicas. Antes de que un proceso de carga dé por buenos sus resultados, debe verificar que los totales cuadran y que no hay valores nulos donde no debería haberlos. Estas comprobaciones pueden ser tan simples como una consulta SQL que lanza una alerta si el resultado no es cero.
Estos tres pasos no resuelven todo, pero sí eliminan los problemas más frecuentes: el cambio sin registro, la prueba en producción y el fallo silencioso de un proceso de carga. A partir de ahí, el equipo puede ir añadiendo automatización de forma gradual, sin necesidad de parar los proyectos en curso.
Para los procesos de carga entre sistemas —cuando el dato tiene que viajar desde un ERP o un CRM hasta la capa analítica—, INTEGRA HUB incorpora mecanismos de control que permiten gestionar ese flujo con trazabilidad y alertas integradas, sin tener que construir esa capa desde cero.
Cómo trabaja Tecnología bi los despliegues de datos
Tecnología bi aplica principios de DevOps en todos los proyectos de datos que implanta, independientemente del tamaño del equipo cliente. Esto significa que cualquier cambio en un modelo, una transformación o un proceso de carga sigue un flujo definido: desarrollo en rama separada, revisión, prueba automática en staging y despliegue controlado a producción.
El resultado para las empresas que trabajan con esta metodología es medible: menos incidencias en producción, menos dependencia de personas concretas para hacer o deshacer cambios, y la capacidad de saber en todo momento qué hay en producción, desde cuándo y por qué.
Este enfoque no es exclusivo de proyectos grandes. Tecnología bi lo aplica también en implantaciones para empresas medianas que están dando sus primeros pasos en Business Intelligence o en la automatización de sus procesos analíticos. La metodología escala con el equipo, no al revés.
Te contamos cómo llevamos los cambios a producción sin romper nada.
Te explicamos nuestra metodología y cómo adaptarla al tamaño y madurez de tu equipo.
Contactar con un especialistaPreguntas frecuentes sobre DevOps
¿Qué es DevOps?
DevOps es un conjunto de prácticas culturales y técnicas que une los equipos de desarrollo y operaciones para desplegar cambios de forma frecuente, controlada y reversible. Su objetivo es eliminar los procesos manuales y la dependencia de personas concretas en el ciclo de entrega de cualquier producto digital, incluidos los proyectos de datos.
¿Qué diferencia hay entre DevOps y DataOps?
DevOps es una disciplina de propósito general aplicable a cualquier producto de software. DataOps toma principios de DevOps, de las metodologías ágiles y del control estadístico de procesos, y los adapta al ciclo de vida del dato, con conceptos propios como el linaje del dato, la calidad automatizada y la trazabilidad de las transformaciones. En la práctica son complementarios: hacer DataOps bien implica aplicar principios DevOps.
¿Únicamente sirve para equipos grandes de desarrollo?
No. Los principios de DevOps son escalables y pueden aplicarse de forma gradual. Un equipo de dos personas puede empezar por versionar sus transformaciones en Git y separar los entornos de desarrollo y producción, obteniendo mejoras inmediatas sin necesidad de infraestructura compleja.
¿Se puede aplicar DevOps a Power BI?
Sí. Power BI permite separar espacios de trabajo de desarrollo y producción, usar repositorios Git para versionar los ficheros de definición de los informes, y automatizar los despliegues entre entornos mediante las APIs de la plataforma y herramientas de CI/CD. Es uno de los casos de uso más frecuentes en empresas españolas que empiezan a adoptar esta forma de trabajar.
¿Por dónde se empieza a implantar DevOps?
El primer paso más impactante es poner bajo control de versiones todo lo que el equipo de datos produce: transformaciones, scripts de carga y definiciones de cuadros de mando. A partir de ahí, separar los entornos de desarrollo y producción y añadir comprobaciones automáticas básicas sobre los datos generados son los siguientes pasos naturales, sin necesidad de montar una plataforma completa desde el inicio.
